NusamandiriNews — Di tengah hiruk-pikuk industri teknologi yang menuntut inovasi tanpa henti, tekanan mental menjadi isu yang kian nyata bagi para pekerjanya. Untuk memetakan seberapa besar kebutuhan dukungan psikologis di lingkungan kerja yang dinamis ini, kecerdasan buatan (Artificial Intelligence/AI) mulai dilirik sebagai alat bantu analisis.
Namun, ada satu batu sandungan klasik di dunia riset data: bagaimana komputer bisa membuat prediksi yang akurat jika informasi yang disodorkan kepadanya bolong-bolong?
Persoalan krusial inilah yang dijawab oleh tim peneliti dari Universitas Nusa Mandiri (UNM) bersama kolaboratornya, yang terdiri dari Sofiyatul Mu’minah, Prof. Dr. Hilman Ferdinandus Pardede, Shinta Oktaviana R, Dr. Eni Heni Hermaliani, Andi Saryoko, Dr. Anton, dan Nurmalasari. Dalam studi yang dipresentasikan pada konferensi internasional ICITRI dan diterbitkan di basis data ilmiah IEEE Xplore ini, mereka menguji metode komputasi cerdas untuk menambal kekosongan data dalam survei kesehatan mental.
Baca juga:Saat Kamera dan AI Berkolaborasi Menyelamatkan Lingkungan dari Menumpuknya Sampah
Ketika Stigma Membuat Data Menjadi “Bolong”
Dalam dunia analisis data, informasi yang tidak lengkap dikenal sebagai missing data. Pada survei kesehatan mental, kekosongan ini sangat lumrah terjadi. Banyak responden memilih melewatkan pertanyaan sensitif karena merasa tidak nyaman atau takut terbentur stigma sosial di tempat kerja.
Sayangnya, lubang informasi ini bisa mengacaukan “otak” komputer. Selama ini, cara paling praktis yang dipakai para analis adalah membuang seluruh data responden yang tidak lengkap, atau menambalnya secara pukul rata dengan jawaban yang paling sering muncul. Padahal, menghapus data sama saja dengan membuang informasi berharga, sementara menebak secara pukul rata sering kali meleset dari kondisi nyata seseorang.
MICE: Menebak Jawaban Lewat Petunjuk Sekitar
Untuk mengatasi dilema tersebut, Sofiyatul Mu’minah dan tim menerapkan teknik bernama Multivariate Imputation by Chained Equations (MICE).
Bayangkan metode MICE ini seperti seorang detektif yang sedang menyusun teka-teki puzzle. Alih-alih menebak satu kepingan yang hilang secara acak, sang detektif akan mengamati gambar pada kepingan-kepingan di sekitarnya untuk memperkirakan bentuk dan warna yang paling masuk akal. Lewat pemodelan yang berulang, MICE membaca hubungan antarjawaban responden untuk memperkirakan isi kolom yang dikosongkan.
Untuk menguji keampuhannya, tim peneliti menggunakan 1.259 catatan survei pekerja industri teknologi dari Open Sourcing Mental Illness (OSMI) tahun 2014 yang memuat 27 atribut informasi. Mereka lalu mengadu tiga strategi penanganan data kosong, penghapusan data, pengisian nilai terbanyak, dan metode MICE, di atas tujuh algoritma pembelajaran mesin (machine learning), termasuk Random Forest, Decision Tree, hingga K-Nearest Neighbors.
Bukti di Laboratorium: Akurasi Melonjak ke 76 Persen
Hasil uji coba menunjukkan bahwa cara kita merawat kualitas data berdampak langsung pada kecerdasan prediksi AI. Berdasarkan rata-rata pengujian dari tujuh model algoritma, berikut perbandingan tingkat akurasinya:
• Metode MICE: Mencapai akurasi tertinggi sebesar 76 persen.
• Penggantian Nilai Paling Sering: Hanya mencatat akurasi 70 persen.
• Penghapusan Data Tidak Lengkap: Berada di posisi terbawah dengan akurasi 67 persen.
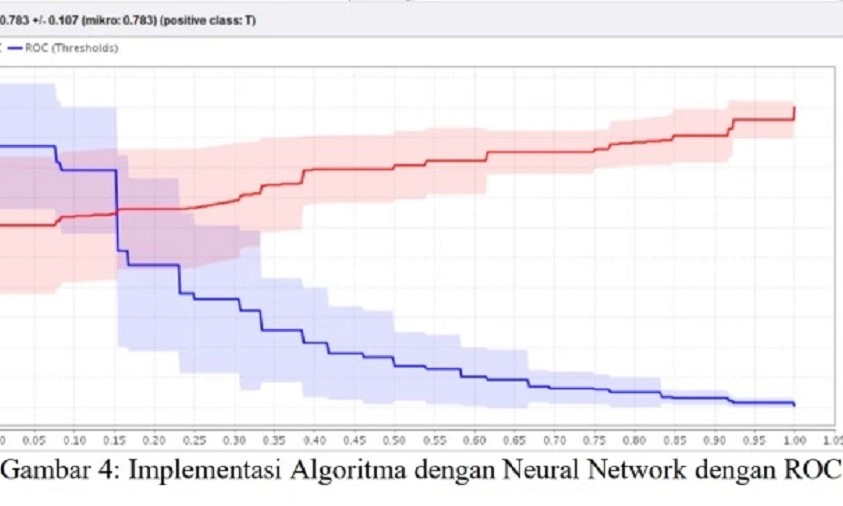
Selain lebih akurat, pengukuran menggunakan indikator Receiver Operating Characteristic (ROC) membuktikan bahwa model yang diolah dengan MICE jauh lebih stabil dan konsisten saat dihadapkan pada data baru yang belum pernah dipelajari sebelumnya.
Tim peneliti juga sempat melakukan simulasi ekstrem dengan sengaja menghapus 30 persen data pada variabel tertentu. Hasilnya, MICE tetap unggul. Pada variabel riwayat kesehatan mental keluarga, tingkat melesetnya MICE hanya 11,4 persen (lebih rendah dari metode nilai terbanyak yang mencapai 12,2 persen). Begitu pula pada variabel kemudahan meminta cuti kesehatan mental, kesalahan estimasi MICE tercatat lebih rendah di angka 15,8 persen dibandingkan metode pembanding sebesar 16,7 persen.
Alat Bantu Pemetaan, Bukan Pengganti Psikolog
Meski terbukti menjanjikan, para peneliti memberikan garis batas yang tegas. Sistem prediksi AI ini dirancang untuk memetakan potensi kebutuhan dukungan psikologis, bukan untuk mengeluarkan diagnosis medis layaknya dokter atau psikolog. Selain itu, penggunaan data survei tahun 2014 membuat pendekatan ini masih perlu diuji ulang menggunakan data pekerja masa kini agar relevan dengan budaya kerja modern.
Kontribusi riset dari UNM sebagai Kampus Digital Bisnis ini mengingatkan kita pada satu prinsip penting di era digital: kecerdasan buatan yang hebat tidak melulu lahir dari algoritma yang rumit, melainkan dari ketelitian merawat kejujuran dan kualitas data. Dengan penanganan informasi yang tepat, teknologi dapat menjadi kompas yang lebih manusiawi untuk menjaga kesejahteraan mental para pekerja.